الممتد 18 عامًا. استكشف خدمات Tarjama المهنية من


المحتويات
1. فجوة التمثيل ليست مادةً للخطابة، بل حقيقةٌ في توزيع البيانات.2. قبل أن يُعمِل النموذج استدلاله في العربية، عليه أن يفكّكها3. الفجوة بنيوية، لا خللٌ في توزيع المفردات4. ما تكشفه معايير التقييم فعلًا5. ما يتلقّاه النظام أهم من مقدار ذكائه6. لماذا يقوم البناء كله على التقييم المفتوح7. ماذا يعني ذلك للمنطقةالمصادرلسنوات، قيل لنا إن سباق الذكاء الاصطناعي يدور حول من يبني أكبر نموذج، ومن يملك أكبر عدد من وحدات معالجة الرسومات، ومن يبلغ الحدود القصوى للتقنية أولًا. هذا جزء من القصة، لكنه ليس الجزء المهم منها.
في 12 سبتمبر، نشر داريو أمودي مقاله «We Must Pace the Frontier»، ويرى فيه أن على هذه الصناعة أن تُبطئ عمدًا وتيرة تحسّن قدرات النماذج، كي تواكبها أعمال المواءمة والسلامة. واقترح ثلاث خطوات: مقيّمون مستقلون من جهات خارجية يعملون بصفة دائمة داخل الشركات، وتنسيق بين الشركات الرائدة في الدول الديمقراطية، ثم تنسيق عالمي في نهاية المطاف. وألزم Anthropic بالخطوة الأولى من جانب واحد. وفي غضون ساعات، أيّد ديميس هاسابيس هذا التوجه، ثم تبعتهما OpenAI.
لنتأمّل طبيعة الخطوة الأولى. إنها ليست اختراقًا بحثيًا، ولا سقفًا للقدرة الحاسوبية، ولا معاهدة، بل التزامٌ بالتقييم: أن يُمنح أشخاص مستقلون وصولًا دائمًا يعادل وصول الموظفين، حتى يتحقق من الادعاءات حول النظام أشخاصٌ غير الذين بنوه.
هذه هي الجملة التي أريد للمنطقة أن تتأملها مليًّا. فجواب المختبرات الرائدة نفسها عن مقولة «إننا نتحرك بسرعة مفرطة» ليس أن نبني أقل، بل أن نقيس أكثر، وعلنًا، وعلى يد أطراف لا مصلحة لها في النتيجة.
والسيادة، إذا فُهمت على وجهها الصحيح، هي الحجة ذاتها مطبّقةً على جغرافيا أخرى. ليست عزلة، وليست إبطاءً، بل هي القدرة على التقييم والتدقيق والتكييف، وعلى الرفض إن لزم الأمر، بشروطك، وبلغتك، وعلى أرضك.
ويتناول ما تبقّى من هذا المقال السبب الذي يجعل العربية تحوّل هذه القدرة إلى متطلب تقني لا تفضيل سياسي. وكل رقم أدناه متاح للعموم ويمكن إعادة التحقق منه.
1. فجوة التمثيل ليست مادةً للخطابة، بل حقيقةٌ في توزيع البيانات.
العربية لغةٌ أم لأكثر من 400 مليون شخص. وفي يونيو 2026، رصدت W3Techs أن العربية لغة 0.6% من المواقع الإلكترونية التي أمكن تحديد لغة محتواها، مقابل 49.7% للإنجليزية.
حصة المواقع الإلكترونية مؤشرٌ تقريبي قاصر على حضور لغةٍ ما على الإنترنت؛ فهو يُغفل كثيرًا من الرسائل، والمحتوى الصوتي، وتعليقات الفيديو، والمنصات المغلقة، والكمّ الهائل من المحتوى العربي الذي لا يصبح أبدًا صفحة مفهرسة. لكنه، على قصوره، قريب من التوزيع الذي تُدرَّب عليه النماذج العامة. وحين تكون مدوّنة التدريب المسبق هي الويب العام، فإن لغةً بنسبة 0.6% ليست أولوية، بل خطأ تقريب يتعلّم النموذج محاكاته على نحو تقريبي.
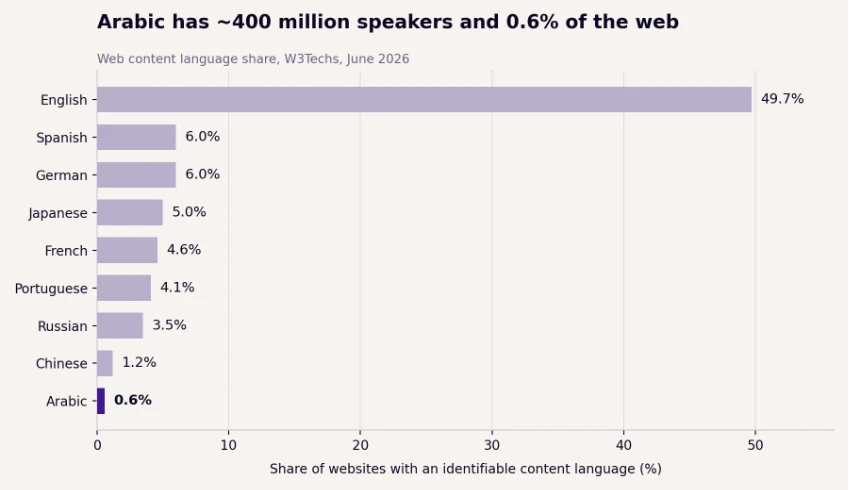
الشكل 1. حصة المواقع الإلكترونية حسب لغة المحتوى. المصدر: W3Techs، يونيو 2026.
هذا أول ما تحجبه عبارة «دعم العربية»: فالتعامل مع الحروف شيء، وإتقان اللغة شيء آخر.
2. قبل أن يُعمِل النموذج استدلاله في العربية، عليه أن يفكّكها
العربية لغةٌ غنية صرفيًا؛ يسكن المعنى فيها الجذورَ والأوزانَ واللواصقَ وعلاماتِ التشكيل الاختيارية، لا ترتيبَ الكلمات على الطريقة الإنجليزية. فأداةٌ قصيرة قد تقلب معنى الجملة، وعلامةٌ غائبة قد تغيّر الكلمة.
المُجزِّئات (أدوات تقسيم النص إلى وحدات نصية) المصمّمة للإنجليزية تتعامل مع هذه البنية تعاملًا سيئًا، وثمن ذلك قابل للقياس. فعلى مدوّنة لغوية عربية واحدة من 39 مليون كلمة، يُنتج مُجزِّئ LLaMA 2 5.38 وحدة نصية لكل كلمة عربية، ولا يُبقي سوى 1.8% من الكلمات العربية سليمةً في وحدة واحدة. أما مُجزِّئ مُكيَّف للعربية، فيبلغ على المدوّنة نفسها 1.71 وحدة لكل كلمة، ونسبة سلامة للكلمات قدرها 63.23%، ويمثّل المدوّنة بـ66.55 مليون وحدة بدلًا من 210.03 مليون، أي بانخفاض يقارب 68%.
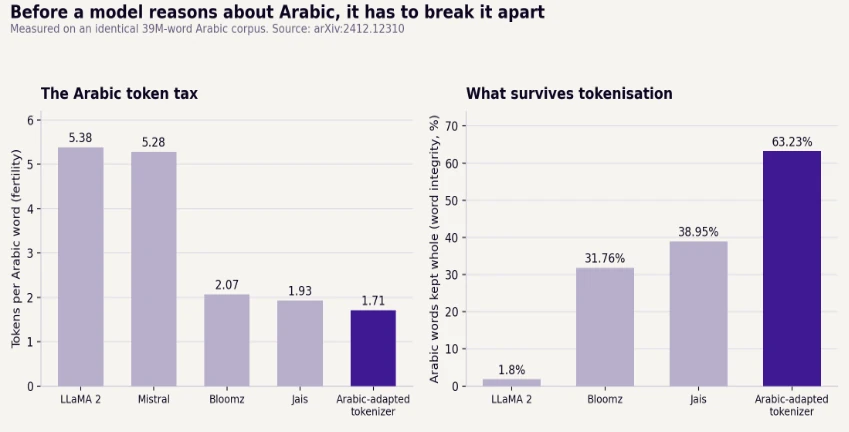
الشكل 2. معدّل التجزئة وسلامة الكلمات العربية في المُجزِّئات، مقيسَين على مدوّنة واحدة من 39 مليون كلمة. المصدر: arXiv:2412.12310.
ويترتب على ذلك أثران، تشعر المؤسسات بكليهما.
الأول يتعلق بالتكلفة والسياق. فاستهلاك نحو ثلاثة أضعاف الوحدات النصية للنص العربي نفسه يعني ثلاثة أضعاف الإنفاق على الاستدلال، وثلاثة أضعاف الضغط على الذاكرة، ونافذة سياق لا تتسع إلا لثلث ما كانت ستستوعبه من مستندك الفعلي.
أما الثاني فأدقّ وأسوأ. ففي دراسات حديثة تقارن بين اللغات، تُفتّت المُجزِّئات الأصلية للنماذج النصَّ العربي بمعدل يقارب 2.4 وحدة نصية لكل كلمة، مقابل 1.5 إلى 1.6 للإنجليزية، ويقترن هذا التفتّت بتراجعٍ أشد في الأداء كلما طالت المدخلات وازدادت تعقيدًا. فالنظام الذي يبدو جيدًا مع موجِّه قصير ليس هو النظام نفسه حين تسلّمونه عقدًا من 40 صفحة.
3. الفجوة بنيوية، لا خللٌ في توزيع المفردات
والاعتراض البديهي أن هذه مشكلة في ميزانية المفردات: امنح العربية حصة أعدل من مفردات المُجزِّئ، وستزول المشكلة.
لكنها لا تزول. فقد اختبر باحثون هذه الفرضية تحديدًا بمُجزِّئ متعدد اللغات منزوع التحيّز، وُزِّعت مفرداته بإنصاف بين اللغات. وجاءت نسب معدّل التجزئة في كل اللغات متقاربة حول 1.0، ما يؤكد عدالة التوزيع. ومع ذلك بقي التفتّت: فقد سجّلت العربية اتساقًا بين الوحدات النصية والوحدات الصرفية قدره 0.10 مقابل 0.42 للإنجليزية، ولم تحمل 89% من الوحدات النصية العربية أي مضمون دلالي، مقابل 58% للإنجليزية.
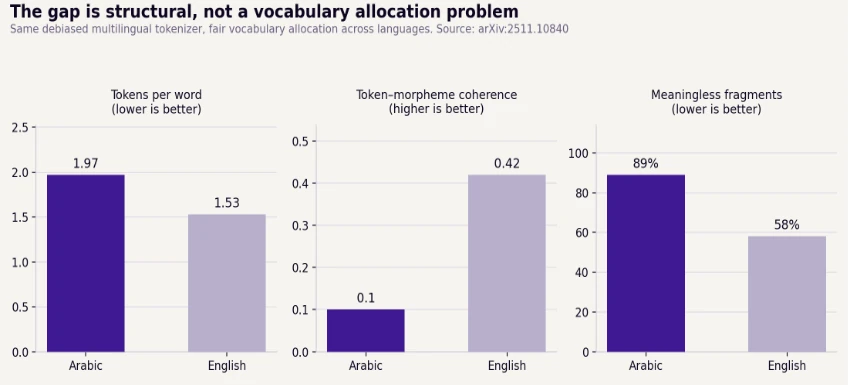
الشكل 3. العربية مقابل الإنجليزية في مُجزِّئ متعدد اللغات منزوع التحيّز يوزّع المفردات بإنصاف. المصدر: arXiv:2511.10840.
وبعبارة بسيطة: حتى مع السخاء في تخصيص المفردات، تقع حدود الوحدات النصية في غير مواضعها في العربية، لأن بنيتها الصرفية لا توجد حيث تبحث عنها خوارزمية صُمِّمت على مقاس الإنجليزية. فكلمة «رادار» تتفتّت إلى بادئة ووسط ولاحقة، وكلمة «يفحص» تنكسر عند حدّ صرفي إلى قطعٍ لا معنى لها.
ولا يُصلَح ذلك بنموذج أكبر، بل بالبناء لهذه اللغة تحديدًا، من طبقة التمثيل صعودًا. وهذا برنامج هندسي، وبرنامج بيانات، وبرنامج لبناء الكفاءات، لا قرار ترخيص.
4. ما تكشفه معايير التقييم فعلًا
في مايو 2026، نشر مركز أبحاث النماذج الأساسية (CRFM) بجامعة ستانفورد لوحة الصدارة HELM Arabic Enterprise، التي تقيّم النماذج في ست مهام مؤسسية باللغة العربية: توليد المقالات، وثلاث صيغ للاستدلال المالي، والإجابة عن الأسئلة القانونية الإماراتية بالرجوع إلى المصادر ودون الرجوع إليها. ويُسجَّل كل موجِّه واستجابة ومقياس ونتيجة، ويمكن إعادة إجراء ذلك كله عبر إطار HELM مفتوح المصدر. تعاونت Arabic.AI في العمل على معيار التقييم؛ أما النتائج فهي نتائج ستانفورد، وقد نُشرت كاملةً، فمن يشكّك فيها يستطيع إعادة إجرائها بنفسه.
إليك النتيجة التي ينبغي أن تعيد صياغة النقاش في المنطقة. يعرض هذا الرسم البياني أفضل نتيجة حققها أي نموذج خضع للتقييم، لا نتيجة نموذجنا ولا نموذج جهة بعينها؛ إنه سقف المجال كله.
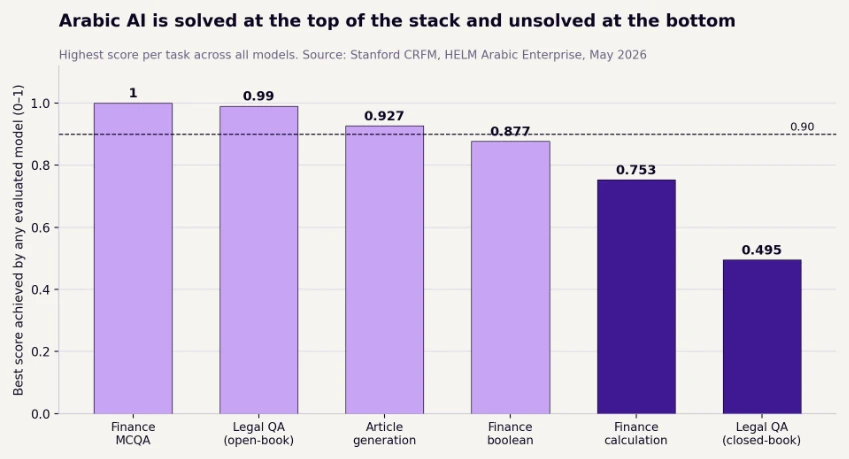
الشكل 4. أعلى نتيجة حققها أي نموذج في كل مهمة. المصدر: مركز CRFM بجامعة ستانفورد، HELM Arabic Enterprise، مايو 2026.
في المجال المالي، بلغت أسئلة الاختيار من متعدد بالعربية حدّ التشبّع فعليًا: نتيجة كاملة قدرها 1.00. وتصل الإجابة عن الأسئلة القانونية بالرجوع إلى المصادر إلى 0.99، ويصل توليد المقالات المؤسسية إلى 0.927.
ثم يهوي المستوى. فالحسابات المالية تبلغ سقفها عند 0.753. ولا تزال العمليات الحسابية دون أدوات غير موثوقة، وفي المجال المالي لا يكون الخطأ الرقمي الصغير خطأً صغيرًا. أما الإجابة عن الأسئلة القانونية الإماراتية دون الرجوع إلى المصادر فتبلغ سقفها عند 0.495، وهي أفضل نتيجة حققها أي نموذج في التقييم. ففي القانون الإماراتي، ومن دون نص تشريعي في الموجِّه، يكاد أفضل ما بلغته التقنية يعادل رمي عملة معدنية.
ولننظر أيضًا إلى ما تخفيه نتيجة توليد المقالات. فقد قيّمت ستانفورد التوليد على ثلاثة محاور منفصلة (الأمانة للمصدر، والاكتمال، والالتزام بالأسلوب) تحديدًا لأن العربية السلسة والعربية الصحيحة إنجازان مختلفان. وحتى عند أعلى نتيجة، 0.927، أضافت نماذج كثيرة حقائق لم ترد في المادة المصدر. فالسلاسة ليست موثوقية، وقد تكون الإجابة الواثقة خاطئة على نحوٍ له تبعات قانونية أو تشغيلية.
5. ما يتلقّاه النظام أهم من مقدار ذكائه
ضع الصيغتين القانونيتين جنبًا إلى جنب، وستخرج حجة السيادة من دائرة الخطابة.
النماذج نفسها، والأسئلة نفسها التي صاغها خبراء قانونيون عرب. والفرق الوحيد هو وجود النص التشريعي ذي الصلة في الموجِّه أو غيابه. بوجوده: 0.99. ومن دونه: 0.495. أي أن الأداء ينخفض إلى النصف.
ويتكرر النمط نفسه في المجال المالي. التعرّف على المفهوم المالي الصحيح في أسئلة الاختيار من متعدد: 1.00. وحساب الإجابة: 0.753.
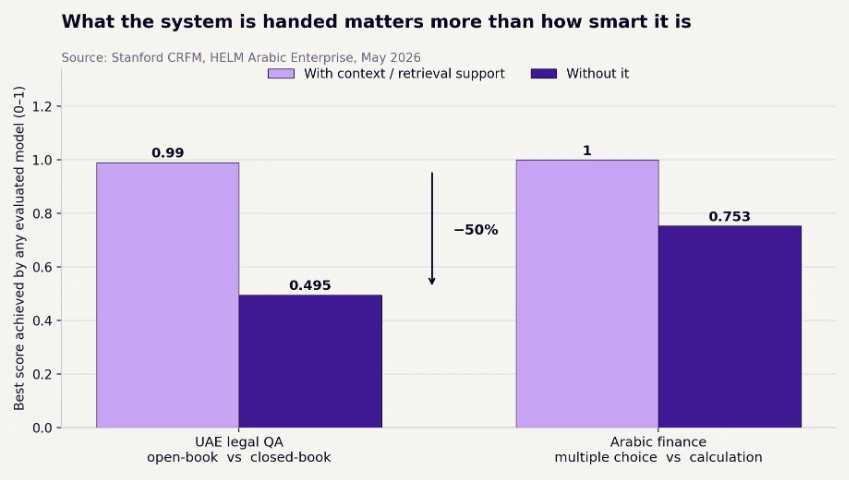
الشكل 5. أثر السياق والأدوات في المهام نفسها. المصدر: مركز CRFM بجامعة ستانفورد، HELM Arabic Enterprise، مايو 2026.
هذه أهم نتيجة على لوحة الصدارة من الناحية التشغيلية، وهي تشير إلى موضع محدد. فالفجوة بين 0.495 و0.99 لا يسدّها نموذج أذكى، بل يسدّها استرجاعٌ يعمل على مستنداتك: تشريعاتك، وتعاميمك، وملفات PDF العربية الممسوحة ضوئيًا لديك، وجداولك، وتنسيقات صفحاتك. والذكاء في مسار المعالجة هذا لا يتركّز في النموذج، بل يتوزّع على إدخال البيانات، والاسترجاع، والإسناد إلى المصادر، والحدود التي يُسمح للنظام بالعمل ضمنها.
ولهذا فإن عبارة «نستخدم أفضل نموذج» ليست استراتيجية للذكاء الاصطناعي، و«موقع الخادم» ليس هو السيادة. فإن كانت أنظمة الاسترجاع لديك، ومنظومة معالجة الكلام، وأدوات فهم المستندات قد بُنيت لنصوص الويب الإنجليزية، فستخفق مع المستندات التي تقوم عليها أعمال مؤسساتك فعلًا، وستخفق بصمت، وهذا هو الإخفاق الأخطر.
6. لماذا يقوم البناء كله على التقييم المفتوح
تفصيلٌ آخر في سجل معيار HELM Arabic من ستانفورد يستحق اهتمامًا أكبر مما لقيه.
صدر الإصدار 1.0.0 من لوحة صدارة HELM Arabic العامة وفيه خلل برمجي: كان السياق يُحذف عند تقييم النماذج في مهام الإجابة عن الأسئلة القائمة على السياق، في اثنين من معايير التقييم السبعة. وقد اكتُشف الخلل، ووُثّق في طلبات دمج علنية، وصُحّح في الإصدار 2.0.0، وأُعلن عنه في تصويب مؤرّخ أُلحق بالمنشور الأصلي، الذي بات يحمل تنبيهًا يُعلم القرّاء بأن أرقامه المنشورة تعود إلى الإصدار السابق الذي استُبدل.
هذا ليس مدعاةً للحرج، بل هو جوهر الحجة كلها.
معيار التقييم المغلق لا يستطيع ذلك، والمعيار الذي يديره مورّدٌ لا مصلحة له فيه. أما لوحة الصدارة التي تنشر كل موجِّه وكل استجابة، وترقّم إصداراتها، وتصحّح أخطاءها علنًا، فإنها تؤدي للتقييم باللغة العربية الدور نفسه الذي يطلب أمودي من جهات التقييم المستقلة أن تؤديه للمختبرات الرائدة: أن تصبح الادعاءات قابلة للتحقق على يد من لم يطلقوها.
لا نستطيع تدقيق ما لا نستطيع قياسه، ولا تفسير إجابة لا نستطيع إسنادها إلى مصدر، ولا إيقاف نظام لا نتحكم فيه. فالتقييم المستقل، بلغاتنا وعلى بنيتنا التحتية الخاصة، متطلبٌ علمي، لا كماليةٌ سياسية.
7. ماذا يعني ذلك للمنطقة
يملك الشرق الأوسط رأس المال، وبنيةً تحتية تُشيَّد بسرعة غير معتادة، وحكومات مستعدة للتحرك، وواحدًا من أكبر المجتمعات اللغوية في العالم. لكن لا شيء من ذلك يتحول من تلقاء نفسه إلى استقلالية في القرار. فاستقلالية القرار قدرةٌ، والأرقام أعلاه تبيّن أين يجب أن تُبنى هذه القدرة.
لا في سباقٍ لتدريب أكبر نموذج، بل في خمس طبقات باتت لوحات الصدارة تكشفها بوضوح:
- التمثيل. تجزئةٌ ونمذجةٌ تنطلقان من العربية أولًا، لأن مشكلة التفتّت بنيوية، وتتفاقم كلما طال المستند.
- الاسترجاع والمستندات. هنا، لا في حجم النموذج، يكمن أكبر عامل منفرد مؤثّر في الأداء قاسه معيار التقييم: فارقٌ يبلغ 2×.
- المعرفة المتخصصة. حين يقف السقف عند 0.495 في الإجابة عن الأسئلة القانونية الإماراتية دون الرجوع إلى المصادر، فذلك يكشف ما لا يعرفه أي نموذج اليوم. هذه المعرفة لا بد أن يبنيها أحد، ولن تُبنى في مكان آخر.
- التقييم. تقييمٌ مفتوح، بإصدارات مرقّمة، يُجرى باللغة نفسها، ويمكن إعادة إجرائه، ولا يتردد في نشر تصويباته.
- مهندسون في الميدان. كل طبقة مما سبق نموذجٌ تشغيلي، لا بندٌ في قائمة المشتريات.
لا تعني السيادة أن نختار بين ذكاء اصطناعي عالمي وآخر محلي. علينا أن نستخدم أفضل النماذج في العالم، وأن نعقد الشراكات مع أفضل المختبرات، وأن نقيس أداءنا بأداء النماذج الرائدة، وأن نجلب أفضل التقنيات إلى المنطقة. لكن الشراكة تبلغ أقصى قوتها بين أنداد، والندّية تتطلب القدرة.
المختبرات الرائدة تقولها اليوم صراحةً: القدرة تتقدّم أسرع من السيطرة، والعلاج يبدأ بالقياس المستقل. والأدلة الآتية من اللغة العربية تقول الشيء نفسه بلسان مختلف: ما لا نستطيع قياسه بلغتنا، لا نستطيع حوكمته في مؤسساتنا.
هذا هو معنى السيادة: لا الإبطاء، بل أن نضمن، حين يتسارع العالم، أن نظل قادرين على رؤية ما يجري، وعلى أن نقول «لا».
المصادر
- Dario Amodei، We Must Pace the Frontier، darioamodei.com، 12 سبتمبر 2026.
- Stanford CRFM، HELM Arabic Enterprise، 26 مايو 2026. crfm.stanford.edu/helm/arabic-enterprise/latest/
- Stanford CRFM، HELM Arabic، 18 ديسمبر 2025، مع تصويب مؤرّخ في 3 يونيو 2026. crfm.stanford.edu/helm/arabic/latest/
- W3Techs، إحصاءات استخدام لغات المحتوى، يونيو 2026.
- Second Language (Arabic) Acquisition of LLMs via Progressive Vocabulary Expansion، arXiv:2412.12310. معدّل التجزئة في المُجزِّئ، وسلامة الكلمات، وعدد الوحدات النصية في المدوّنة.
- Tracing Multilingual Representations in LLMs with Cross-Layer Transcoders، arXiv:2511.10840. اتساق الوحدات النصية مع الوحدات الصرفية، ومعدلات الأجزاء الخالية من المعنى.
- Cross-Lingual Empirical Evaluation of Large Language Models for Arabic Medical Tasks، arXiv:2602.05374. تفتّت النص في المُجزِّئات الأصلية للنماذج، العربية مقابل الإنجليزية.
أسّست الشركة عام 2008، وأمضت قرابة عقدين في بناء بنية تحتية مؤسسية للغة العربية، وتقود اليوم تحوّل المنصة نحو الذكاء الاصطناعي.